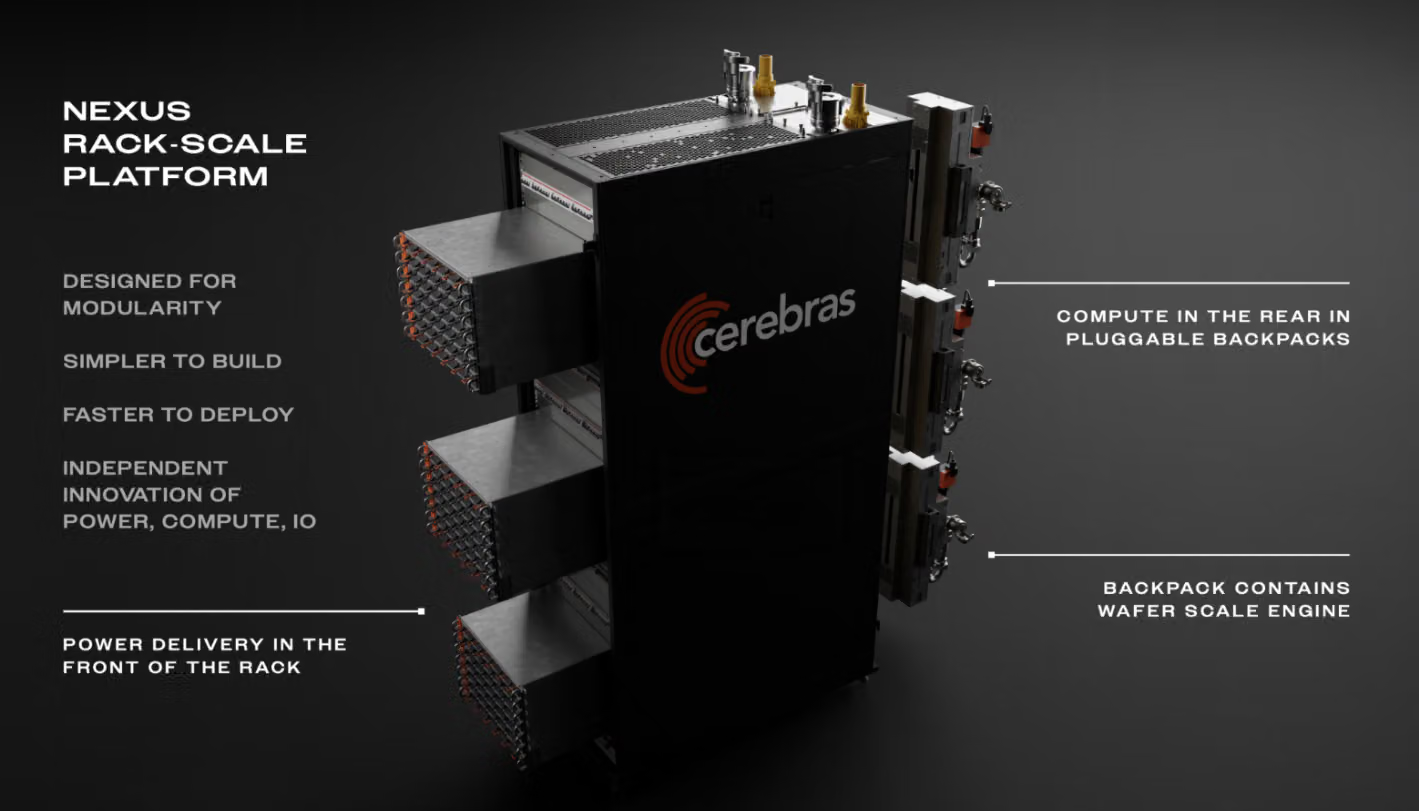
1. Il chip: WSE (Wafer Scale Engine)
Mentre aziende come NVIDIA o AMD producono schede grafiche tagliando un disco di silicio (wafer) in centinaia di piccole GPU separate, Cerebras utilizza l’intero wafer di silicio come un unico processore. Vedi Cerebras WSE Introduction per saperne di più.
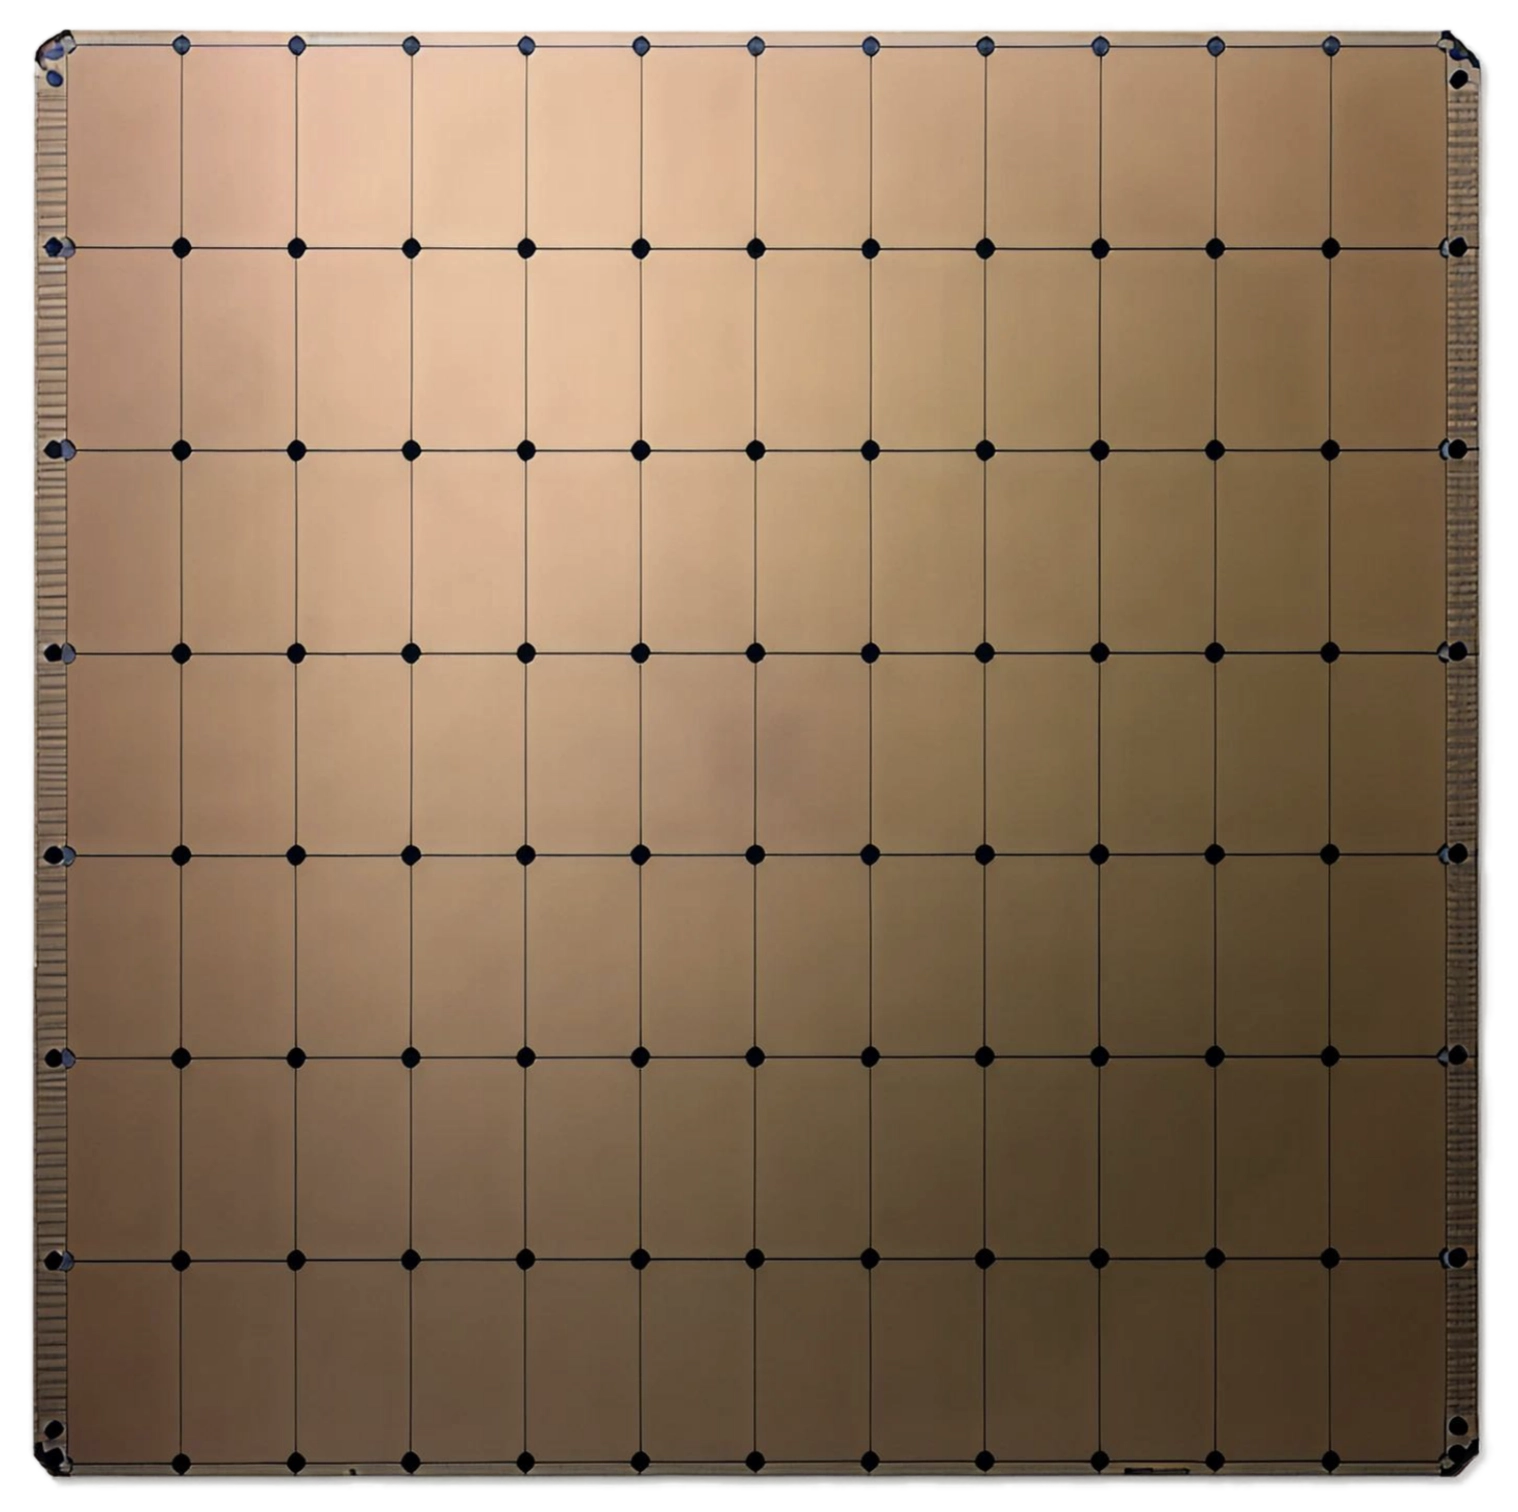
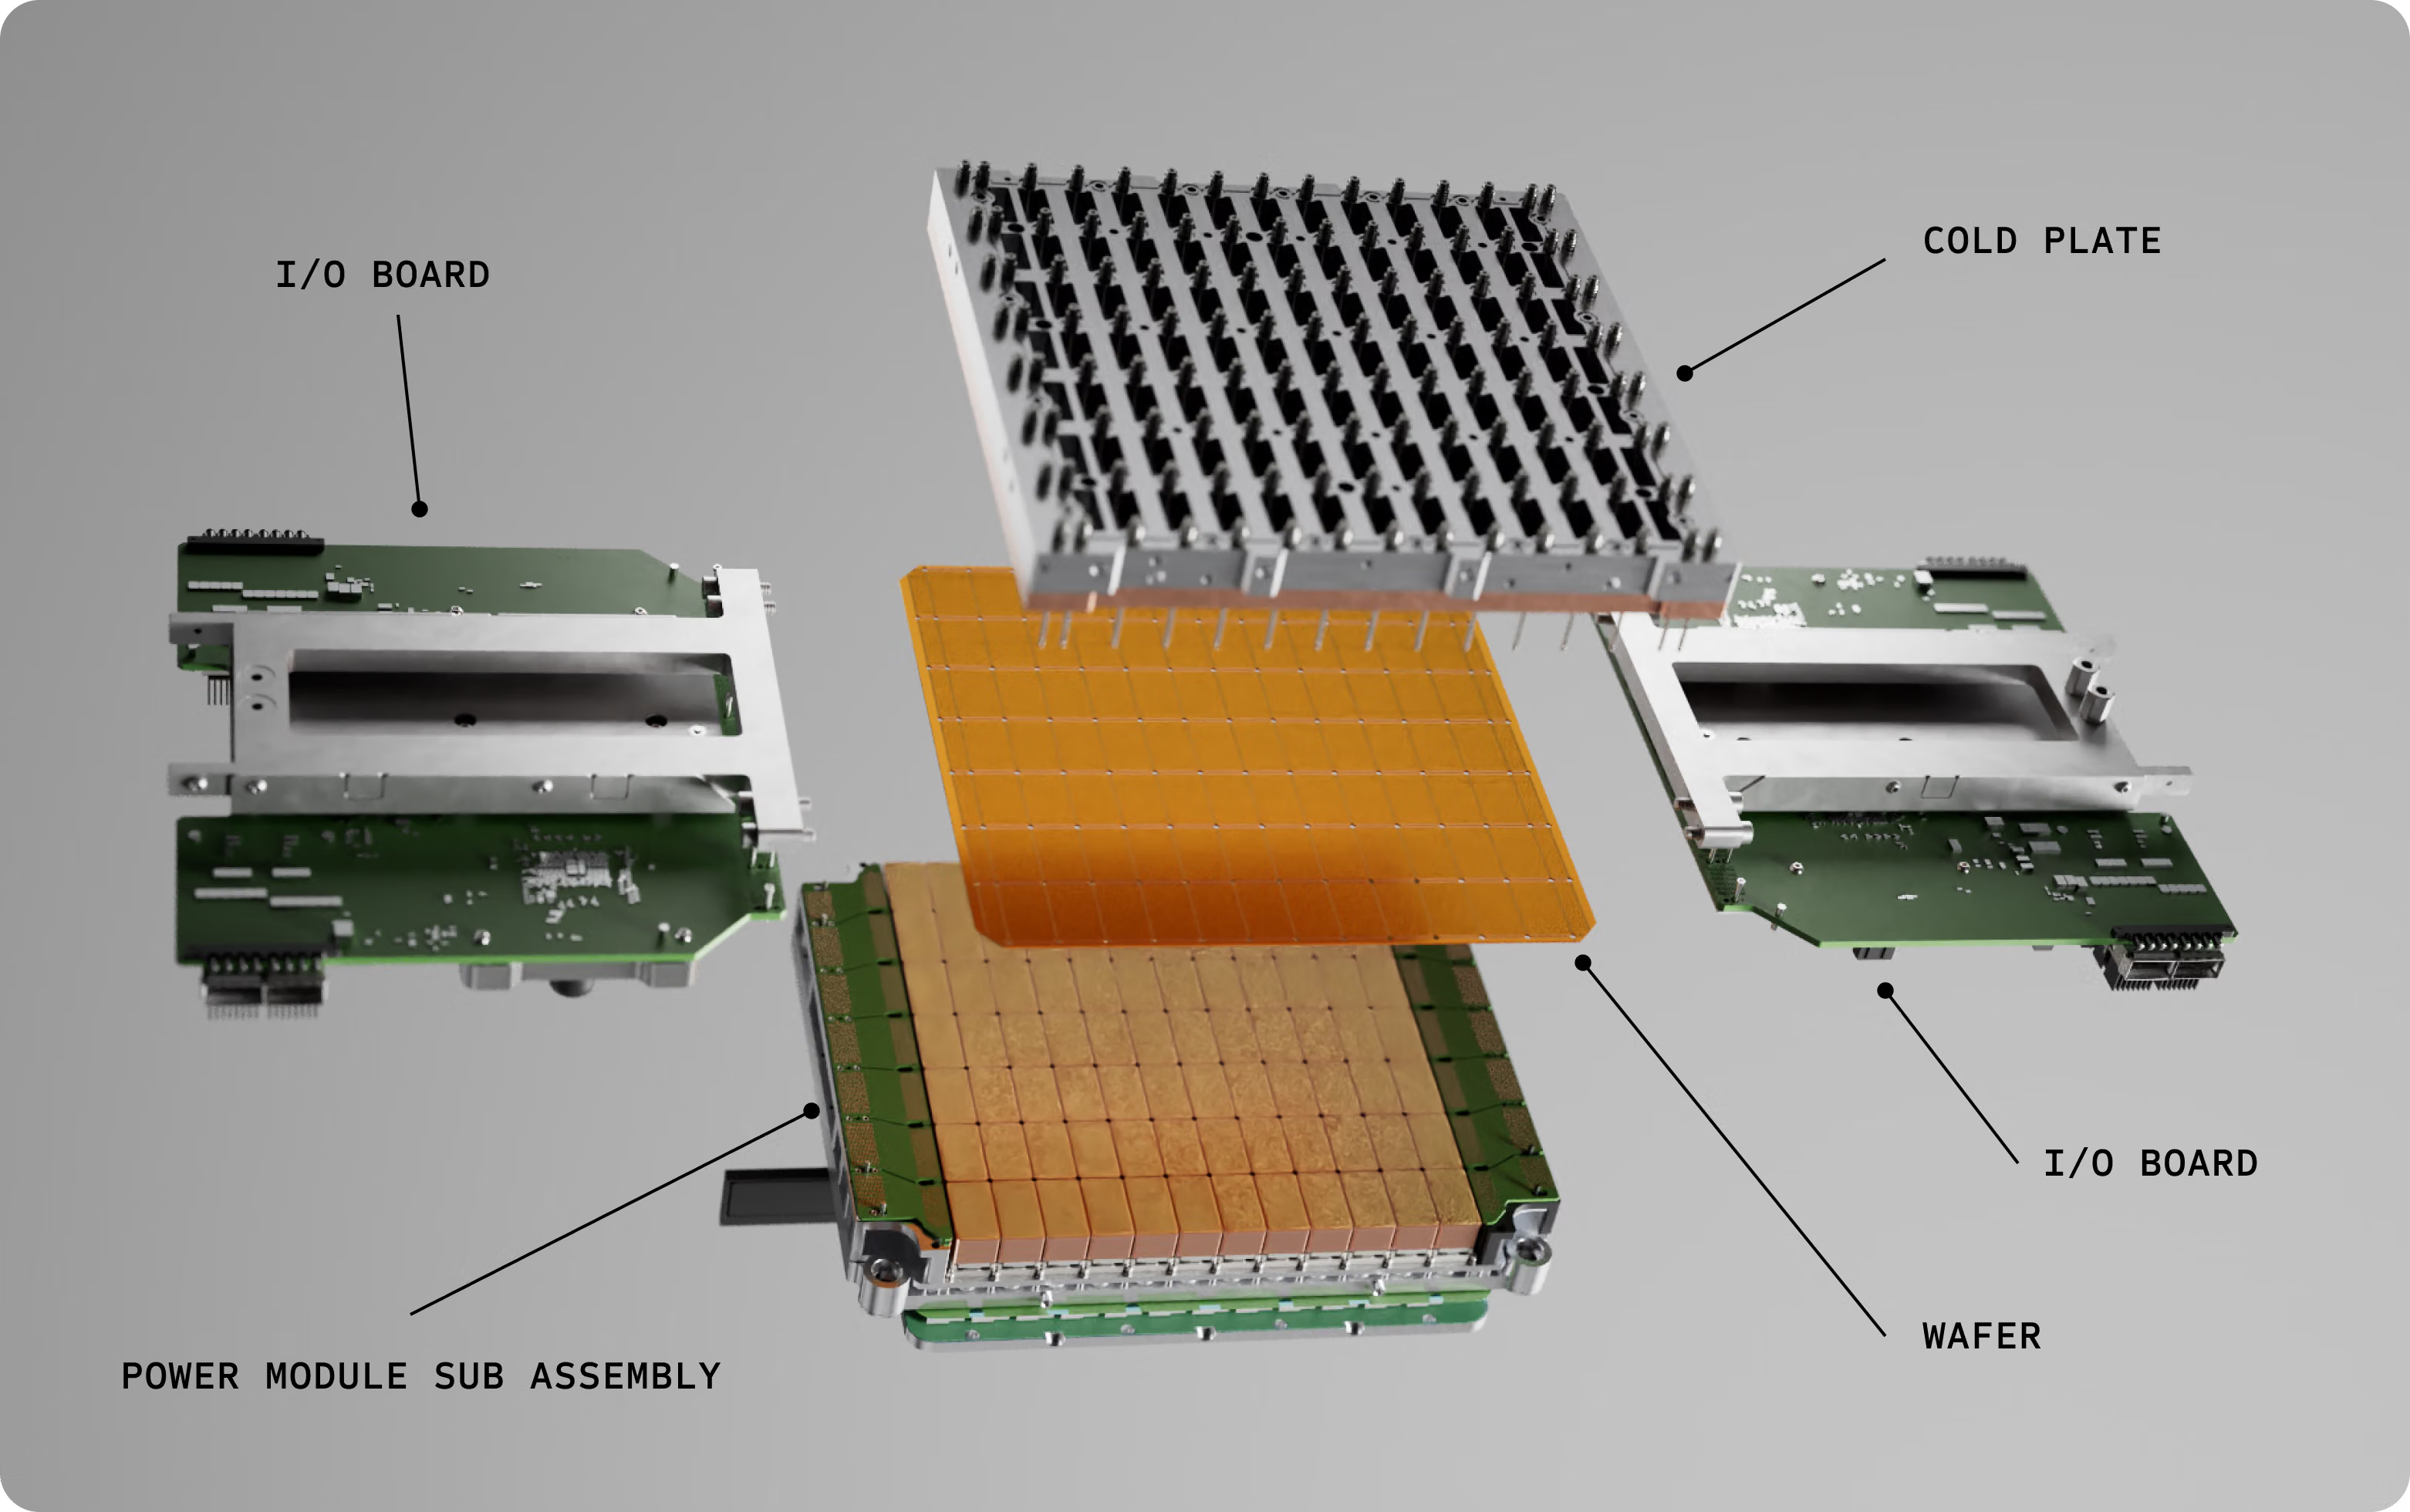
2. Il server singolo: CS-3 (Cerebras System 3)
Il CS-3 è lo chassis fisico (occupa circa 15 unità rack, ossia circa un terzo di un armadio rack standard) costruito attorno al chip WSE-3. Poiché l’intero wafer consuma fino a 23 kW di potenza, lo chassis include un sistema proprietario di raffreddamento a liquido interno (water-to-air) e alimentatori dedicati.
3. Gestione della memoria esterna: MemoryX e SwarmX
Poiché 44 GB di SRAM non bastano per contenere i grandi modelli linguistici (LLM) da centinaia di miliardi o trilioni di parametri, Cerebras ha separato il calcolo dalla memoria dei pesi:
- MemoryX: Server di memoria esterni che contengono i pesi del modello AI (fino a 1,2 Petabyte di capacità).
- SwarmX: Uno switch di rete ad altissima velocità che trasmette (streamma) i dati del modello dai moduli MemoryX al chip CS-3 livello per livello durante l’esecuzione del calcolo (tecnologia denominata Weight Streaming).
4. I Rack e i Supercomputer (Cluster come Condor Galaxy)
Quando è necessaria una potenza di calcolo maggiore, più unità CS-3 vengono collegate insieme all’interno di rack con i moduli SwarmX e MemoryX.
- Semplicità software: Nei cluster di GPU tradizionali, i programmatori devono dividere e sincronizzare manualmente il codice su migliaia di schede. Nei supercomputer Cerebras, l’architettura di streaming fa sì che un intero cluster di decine o centinaia di CS-3 venga gestito dal software come se fosse un’unica GPU gigante.
- Scalabilità: I sistemi possono scalare da 4 fino a 2.048 nodi CS-3 interconnessi, erogando una potenza di calcolo nell’ordine degli Exaflops.